AI 크롤러 방치하다 구글 색인 날아가는 이유
어제까지 구글 1페이지에 있던 핵심 페이지가 오늘 아침 갑자기 색인에서 사라졌습니다. 서버가 다운된 적도 없는데 말이죠. AI 크롤러의 무차별적인 동시 요청이 웹 서버의 렌더링 자원을 고갈시키면서, 검색엔진 로봇에 빈 HTML이나 타임아웃 페이지만 전달되어 정규 URL(Canonical URL) 구조가 통째로 무너진 결과입니다.
"AI 크롤러를 막으면 검색 노출이 완전히 망가진다"는 두려움 때문에 트래픽을 방치하는 웹사이트가 많아요. 하지만 제어되지 않은 AI 봇을 그대로 두는 것은 검색 가시성을 높이는 게 아니라, 오히려 원본 콘텐츠의 인덱싱 자체를 파괴하는 지름길이 될 수 있어요.
트래픽 300% 폭증 속 벌어지는 인프라 자원 잠식
AI 크롤러의 데이터 수집량은 기존 검색엔진 로봇의 크롤링 주기와는 비교할 수 없을 정도로 가파르게 치솟고 있어요. zdnet.co.kr에 보도된 아카마이테크놀로지스 보고서에 따르면, AI 봇 활동은 1년 새 300% 이상 급증했어요. 전체 봇 트래픽 중 AI 봇이 차지하는 비중은 아직 약 1% 수준에 불과하지만, 이 작은 비중이 웹 서버에 미치는 충격은 상상을 초월해요.
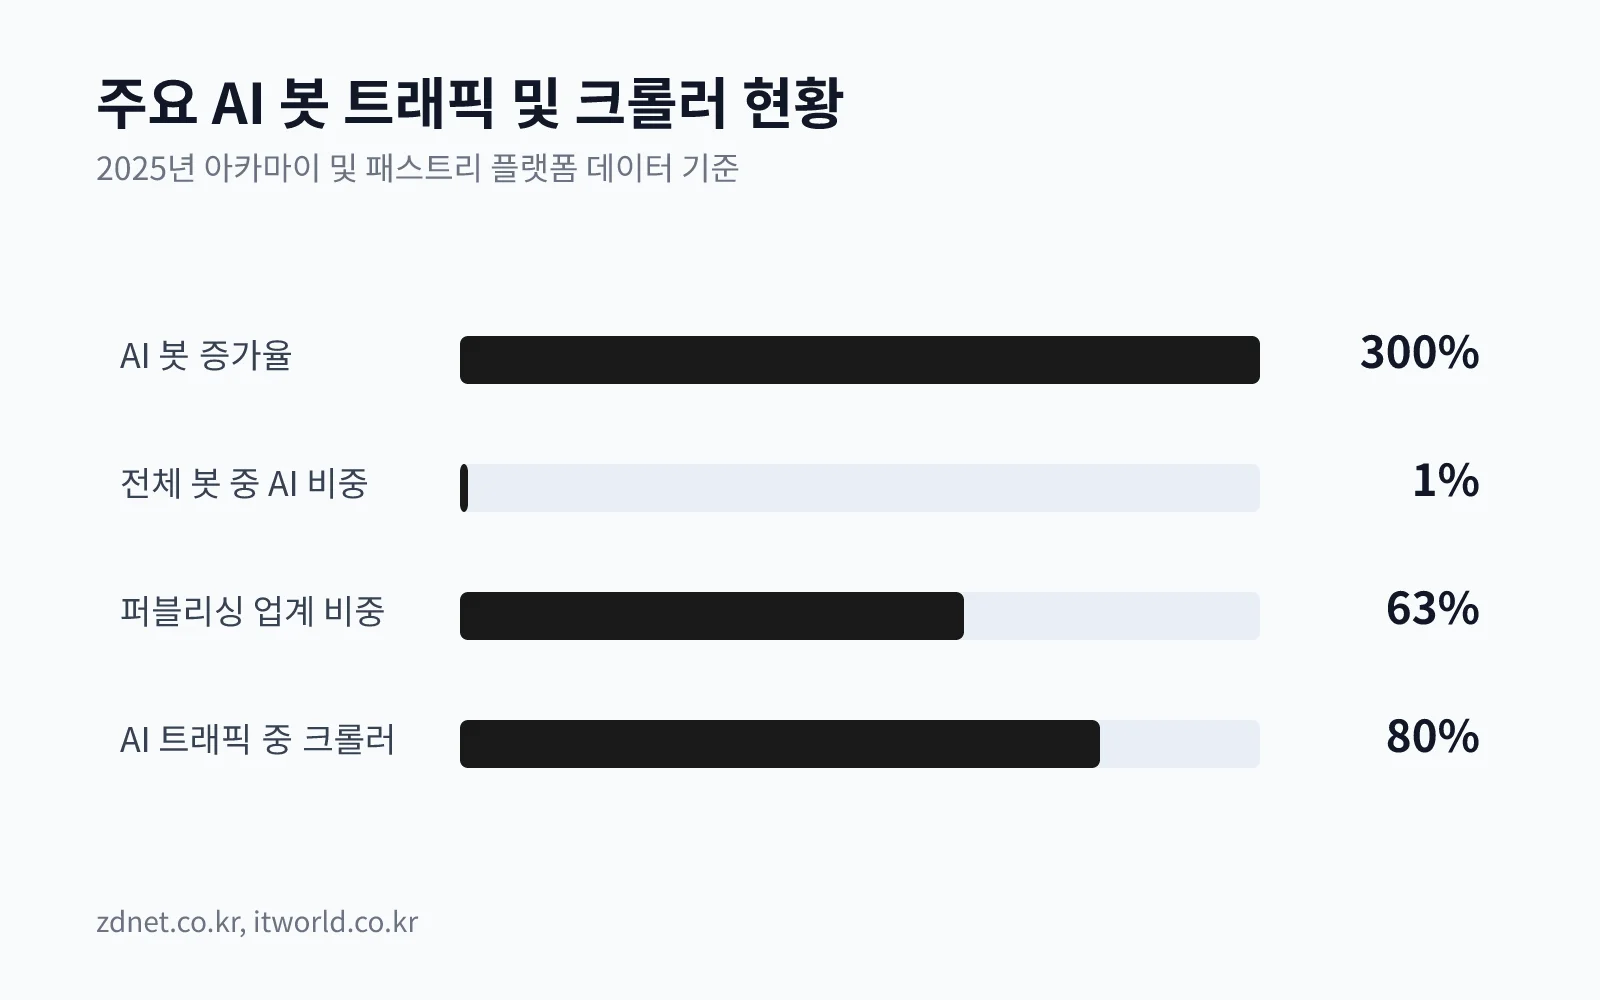
itworld.co.kr에 공개된 패스트리(Fastly)의 분석 결과에 따르면, AI 봇 트래픽의 약 80%가 대규모 데이터를 긁어모으는 AI 크롤러에 의해 발생하고 있어요. 심지어 특정 웹사이트에서는 단 하나의 페처 봇이 1분 동안 무려 3만 9,000건의 요청을 쏟아부은 사례까지 확인되었을 정도예요.
특히 텍스트와 최신 정보가 풍부한 산업군이 표적이 되고 있어요. 아카마이 조사에서 퍼블리싱 업계는 AI 봇 트리거의 63%를 차지했고, 커머스 분야에서는 불과 두 달 동안 250억 건 이상의 봇 요청이 집중되었어요. 헬스케어 분야 역시 AI 봇 활동의 90% 이상이 무단 데이터 수집을 노린 스크래핑성 활동으로 드러났어요. 정교하게 분산 제어되지 않은 봇 트래픽은 웹 서버를 한계치까지 몰아붙이고 있어요.
Canonical URL 유실과 렌더링 타임아웃의 메커니즘
수만 건의 AI 봇 요청이 SSR 렌더링 자원을 선점하면, 뒤이어 유입된 검색엔진 크롤러는 504 타임아웃을 받거나 <link rel="canonical"> 태그가 누락된 빈 HTML을 전달받게 됩니다.
| 비교 항목 | 기존 검색엔진 크롤러 (예: Googlebot) | 무제한 AI 크롤러 (데이터 스크래핑 봇) |
|---|---|---|
| 수집 주기 및 속도 | 서버 응답 속도에 맞춰 크롤링 예산 자동 조절 | 제한 없는 동시 다발적 대량 호출 위주 |
| 자원 소모 특성 | 정적 캐시 우선 수집, 효율적 리소스 관리 | 딥링크·변수형 URL까지 무차별 렌더링 요청 |
| 인덱싱 충돌 결과 | 타임아웃 발생 시 크롤링 빈도를 스스로 낮춤 | 서버 부하 유발 → 빈 페이지 유입 → 원본 링크 유실 |
이로 인해 검색엔진이 정상 문서를 "빈 껍데기나 삭제된 페이지"로 오인하여 기존 색인을 제거하게 되며, 결과적으로 AI 답변의 인용 출처는 물론 기존 오가닉 검색 순위까지 한순간에 붕괴됩니다.
빅테크 봇의 독주와 GEO 관점의 위기
AI 크롤러 환경은 특정 플랫폼의 과점 현상이 두드러지면서 서버 관리의 불확실성을 더 키우고 있어요. 2025년 패스트리의 트래픽 분석에 따르면, AI 크롤러 트래픽 중 메타(Meta)가 차지하는 비중이 절반 이상에 달해 구글과 오픈AI를 합친 트래픽 규모를 넘어섰어요. 거대 빅테크들이 모델 학습용 데이터와 실시간 검색 데이터를 경쟁적으로 확보하면서 수집 경쟁이 갈수록 과열되는 양상이에요.
이런 상황에서 무조건 모든 봇을 열어두는 것은 검색 노출에 득이 되지 않아요. 반대로 모든 AI 봇을 robots.txt로 전면 차단하면 ChatGPT, 퍼플렉시티 같은 생성형 검색 결과에서 우리 브랜드가 아예 인용되지 않는 문제가 생기죠.
결국 생성형 엔진 최적화(GEO)의 핵심은 '무조건적인 개방'이 아니라 '인프라를 지키는 선별적 제어'예요. 실시간 AI 검색 답변에서 브랜드 신뢰도를 확보하려면, 원본 링크가 깨지지 않도록 가시성을 정밀하게 모니터링하는 플랫폼의 역할이 중요해졌어요. 이 과정에서 전문적인 GEO 진단과 모니터링 기능을 제공하는 BaRam 같은 솔루션을 참고하면, AI 검색 환경 내 원본 링크 보존 상태와 브랜드 노출 점수를 객관적으로 점검하는 데 큰 도움이 돼요.
원본 링크를 지키는 3단계 기술적 대응법
인덱싱 충돌로 원본 링크가 깨지는 사태를 막으려면 서버 로그 확인부터 시작해 단계적으로 방어벽을 세워야 해요.
1. 웹 서버 로그에서 비정상적인 페처 식별
웹 서버 액세스 로그에서 짧은 시간 동안 단일 IP 대역이나 특정 User-Agent를 통해 대량의 429(Too Many Requests), 503, 504 에러를 유발하는 주체를 확인하세요. 단순 브라우저 접근인지, 렌더링 리소스를 과도하게 요청하는 학습용 크롤러인지 분리해 집계하는 작업이 먼저예요.
2. robots.txt 역할 분리와 크롤 딜레이 적용
모든 AI 봇을 한데 묶지 말고, 검색 인용을 담당하는 봇과 무차별 학습용 스크래퍼를 구분해야 해요. 학습 전용 봇의 무리한 접근은 차단하되, 주요 AI 검색 페처에는 적절한 수집 간격을 유도하는 설정이 필요해요.
# 데이터 무단 스크래핑 봇 선별 제어
User-agent: CCBot
Disallow: /

# 주요 AI 검색 엔진 크롤러 접근 허용 및 경로 지정
User-agent: GPTBot
Allow: /
Disallow: /api/
Disallow: /search/
3. CDN 및 리버스 프록시 단의 Rate Limiting 구축
서버 애플리케이션에 요청이 닿기 전, 클라우드플레어나 패스트리 같은 엣지 단에서 IP 및 User-Agent 기반의 요청 속도 제한(Rate Limiting)을 걸어두세요. 분당 요청 수를 안전한 수준으로 제한하면 렌더링 서버가 뻗는 사고를 방지하고, 구글봇과 정상적인 사용자에게 언제나 온전한 Canonical 태그를 반환할 수 있어요.
함께 읽으면 좋은 글: AI 검색이 바꾼 구글 SEO 핵심 변화 3가지 · AI 검색 키워드 전략, 구글 SEO만 믿다간 콘텐츠 전부 망한다 · 초보 식당 사장님, AI 검색용 메뉴판은 왜 따로 만들어야 할까
자주 묻는 질문
Q. AI 크롤러를 일부 제한하면 생성형 엔진(GEO) 가시성이 떨어지지 않나요? 서버가 감당하지 못할 트래픽을 방치해 404나 500 에러를 반환하는 상태가 가시성에 훨씬 치명적이에요. 정상적인 페이지가 100% 서빙될 수 있도록 속도 제한을 거는 것이 오히려 AI 검색 인용 확률을 지키는 길이에요.
Q. 정규화 태그(Canonical URL)가 깨졌는지는 어떻게 감지하나요? 구글 서치 콘솔의 '색인 생성' 리포트에서 "적절한 표준 태그가 포함된 대체 페이지" 또는 "크롤링됨 - 현재 색인이 생성되지 않음" 상태로 빠진 URL이 급증했는지 살펴보세요. 동시에 서버 로그에서 해당 페이지 크롤링 시점의 응답 코드가 200이었는지 확인해야 해요.
생성형 검색 시대의 검색엔진 최적화는 단순히 좋은 글을 쓰는 데서 끝나지 않고, 봇 트래픽 속에서 원본 페이지의 기술적 무결성을 유지하는 인프라 관리까지 포함해요. 내 웹사이트의 원본 링크가 AI 엔진 속에서 제대로 인용되고 있는지 점검하고 체계적인 생성형 검색 대응 전략을 세우고 싶다면, BaRam에서 현재 사이트의 가시성 상태를 확인해 보세요.
*이 콘텐츠는 AI의 도움을 받아 작성되었으며, BaRam 팀이 내용을 검토하였습니다.